

OpenAI’s Jalapeño ASIC is voor het eerst publiek vergeleken met Nvidia’s GB300-racks. Volgens door OpenAI gedeelde benchmarks levert de in eigen huis ontwikkelde inferentiechip meer throughput per kilowatt en lagere latency, maar de vergelijking kent duidelijke kanttekeningen. Het gaat om testresultaten op specifieke open modellen en instellingen, niet om een algemene uitspraak over alle AI-workloads.
Meer technologienieuws vind je op de TostieTech Tech-nieuwspagina.
Eerste publieke vergelijking van Jalapeño ASIC met Nvidia GB300
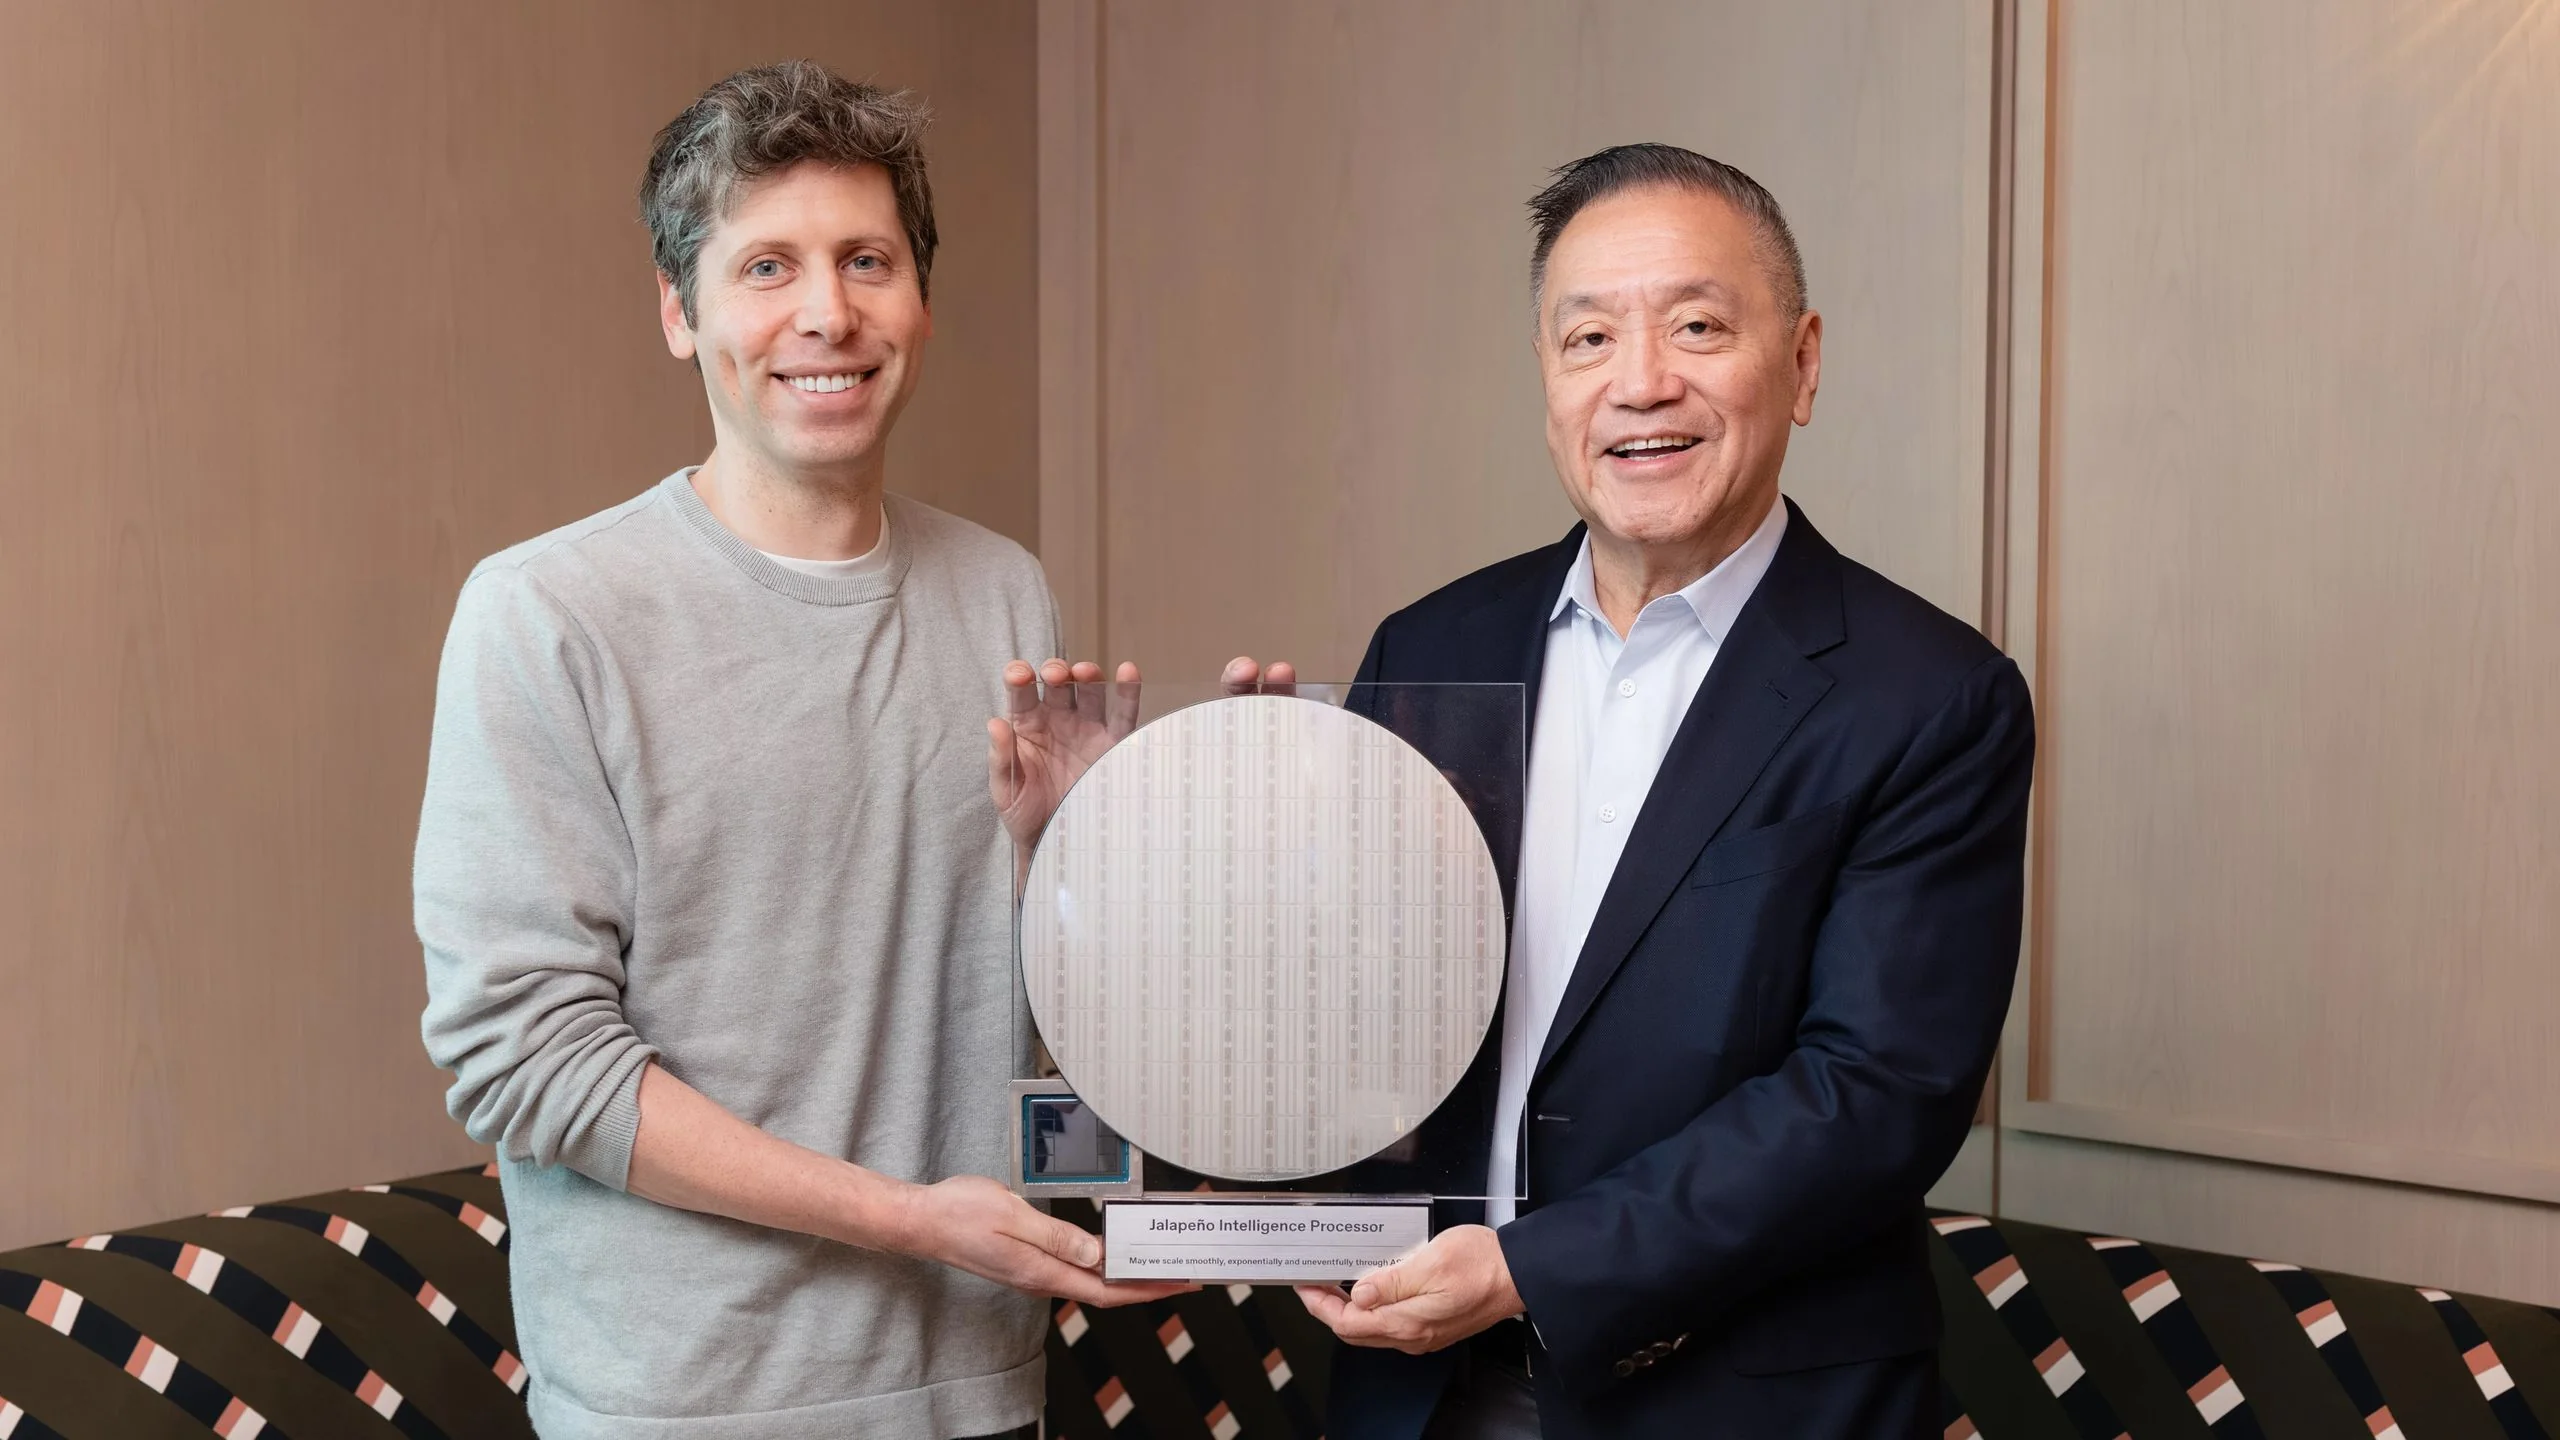
OpenAI presenteerde op Hot Chips benchmarks van zijn eerste eigen chip voor inferentie, Jalapeño. De chip is samen met Broadcom ontwikkeld en is bedoeld voor gebruik in OpenAI’s datacenters. In de vergelijking zette OpenAI de 700W-chip af tegen Nvidia’s GB200- en GB300-racks, die volgens de bron op respectievelijk 1.200W en 1.400W zijn gespecificeerd.
Op SemiAnalysis’ openbare InferenceX-suite claimt OpenAI een voordeel van 1,5x tot 1,9x in throughput per kilowatt en 1,7x tot 3,6x lagere end-to-end latency. OpenAI zegt daarbij dat de grootste winst zichtbaar is bij lage-latency-instellingen. In die meetpunten zou de chip zelfs 8,6x tot 104,3x meer throughput per kilowatt halen dan de snelste eerdere time-between-tokens-instellingen van de GB300 in die suite.
Wat Jalapeño ASIC precies doet
Jalapeño is geen trainingchip, maar een ASIC voor inferentie: het uitvoeren van al getrainde modellen. Dat is belangrijk, want Nvidia’s hardware blijft volgens de aangeleverde bron juist onbetwist in het trainen van modellen. OpenAI richt zich met Jalapeño op het verplaatsen van een deel van de inferentiewerkbelasting naar eigen silicium.
Elke package combineert de compute-die met zes HBM4-stacks, goed voor 216 GiB geheugen en 15,4 TB/s bandbreedte. Daarmee heeft Jalapeño per watt aan gespecificeerde vermogensclassificatie ongeveer 50% meer geheugen dan de GB300, die 288GB HBM3E draagt bij een rating van 1.400W. OpenAI stelt dat zijn architectuur vooral ontworpen is om de totale HBM-bandbreedte beter bloot te leggen, niet om per se nóg meer geheugen toe te voegen.
De vergelijking met Nvidia is nuttig, maar niet volledig
OpenAI normaliseerde de resultaten op basis van de gepubliceerde package TDP van de chips. Tegelijk meldde het bedrijf dat het gemeten aanhoudende stroomverbruik van Jalapeño in tests op of onder 550W lag. In een appendix-vergelijking op basis van totale utility power per accelerator worden de verschillen kleiner: 1,18kW voor Jalapeño tegenover 2,55kW voor de GB300.
Ook de testopzet is relevant. De belangrijkste cijfers zijn gebaseerd op single-token prediction op de GB300, terwijl productie-omgevingen van Nvidia vaak multi-token prediction gebruiken. In een vergelijking tegen een GB300-configuratie met multi-token prediction slinkt het efficiëntievoordeel van Jalapeño tot ongeveer 1,5x. Verder is Jalapeño niet vergeleken met Nvidia’s Vera Rubin-platform, dat later moet verschijnen en volgens de bron bedoeld is voor de eerste gigawatt aan Nvidia-systemen die OpenAI in de tweede helft van 2026 wil inzetten.
Leveringsketen en volgende generatie
Naast prestaties is ook beschikbaarheid een factor. De aangeleverde bron noemt een brede HBM-schaarste: Samsung, SK hynix en Micron zouden HBM-capaciteit tot en met 2027 grotendeels al hebben verkocht. Micron benadrukte op dezelfde conferentie dat HBM ongeveer drie keer zoveel waferoppervlak kost als DDR5 bij gelijke capaciteit.
Dat maakt OpenAI’s plannen voor opschaling gevoelig voor dezelfde productieketens als die van Nvidia, met TSMC, HBM-leveranciers en geavanceerde packaging als knelpunten. Volgens de bron werkt OpenAI al aan een tweede generatie chip die binnen maanden richting tape-out zou gaan, terwijl conceptwerk aan een derde generatie loopt.
TostieTech duiding
De belangrijkste nuance is dat OpenAI hier zelf de meetlat neerzet. Jalapeño lijkt vooral sterk op de combinatie van inferentie, geheugenbandbreedte en energie-efficiëntie binnen een afgebakende benchmarkset. Dat is relevant voor datacenters waar latentie en stroomverbruik direct doorwerken in kosten en capaciteit.
Tegelijk blijft de vergelijking smal. Nvidia’s GB300 is niet de enige relevante referentie, en OpenAI testte niet tegen Vera Rubin. Ook is het verschil tussen single-token en multi-token inference niet triviaal: wie productie-werklasten vergelijkt, moet weten welke generatie inference-opzet wordt gebruikt. De claim dat Jalapeño efficiënter is dan de GB300 zegt dus vooral iets over deze specifieke testcondities, niet over een definitieve koppositie in alle AI-hardware.
Voor consumenten is de directe impact klein, maar de bredere lijn is duidelijk: grote AI-bedrijven bouwen steeds vaker eigen chips om minder afhankelijk te zijn van Nvidia en om hun stroom- en geheugenbudget preciezer te sturen. Als de benchmarkclaims in de praktijk overeind blijven, verschuift de concurrentie in AI-inferentie steeds meer van pure rekenkracht naar systeemontwerp, geheugenaanvoer en energieverbruik.
Bron: Tom's Hardware