

TypeSafe AI zet met probabilistische besluitvorming in op een ander soort AI dan de bekende chatbots. Jev, het eerste zogeheten System One-model van het bedrijf, is volgens TypeSafe niet gemaakt om lange antwoorden te genereren, maar om concrete uitspraken te beoordelen en er een kansscore aan te koppelen. Daardoor moet het beter passen in code en workflows dan een klassieke LLM. In de brontekst wordt Jev neergezet als een model dat vooral voor programmeertoepassingen bedoeld is: het levert geen open gesprek, maar een gestructureerde beoordeling van een situatie op basis van de meegegeven context.
Meer technologienieuws vind je op de TostieTech Tech-nieuwspagina.
Jev als System One-model voor probabilistische besluitvorming
TypeSafe AI noemt Jev zijn eerste System One-model en positioneert het nadrukkelijk als alternatief voor chatgerichte LLM’s. De kern van die aanpak is dat het systeem geen vrije dialoog voert zoals een chatbot, maar specifieke statements of vragen beoordeelt op basis van een aangeleverde toestand met data. Daardoor verschuift de rol van het model van tekstgenerator naar beslismodule. Volgens de bron is dat vooral relevant voor programmeertoepassingen, waar software niet per se een antwoord in natuurlijke taal nodig heeft, maar een uitkomst waarop direct vervolglogica kan worden gebouwd.
Jev werkt daarbij met een confidence factor. In plaats van een lang, uitleggerig antwoord geeft het model een beoordeling van een bepaalde situatie of bewering, gecombineerd met een waarschijnlijkheid. Dat past bij de focus op probabilistische besluitvorming: niet het formuleren van een redenering staat centraal, maar het schatten van de kans dat een bepaalde uitspraak klopt. Voor ontwikkelaars moet dat het gebruik van AI in code overzichtelijker maken, omdat het model direct aansluit op beslissingen die software al moet nemen.
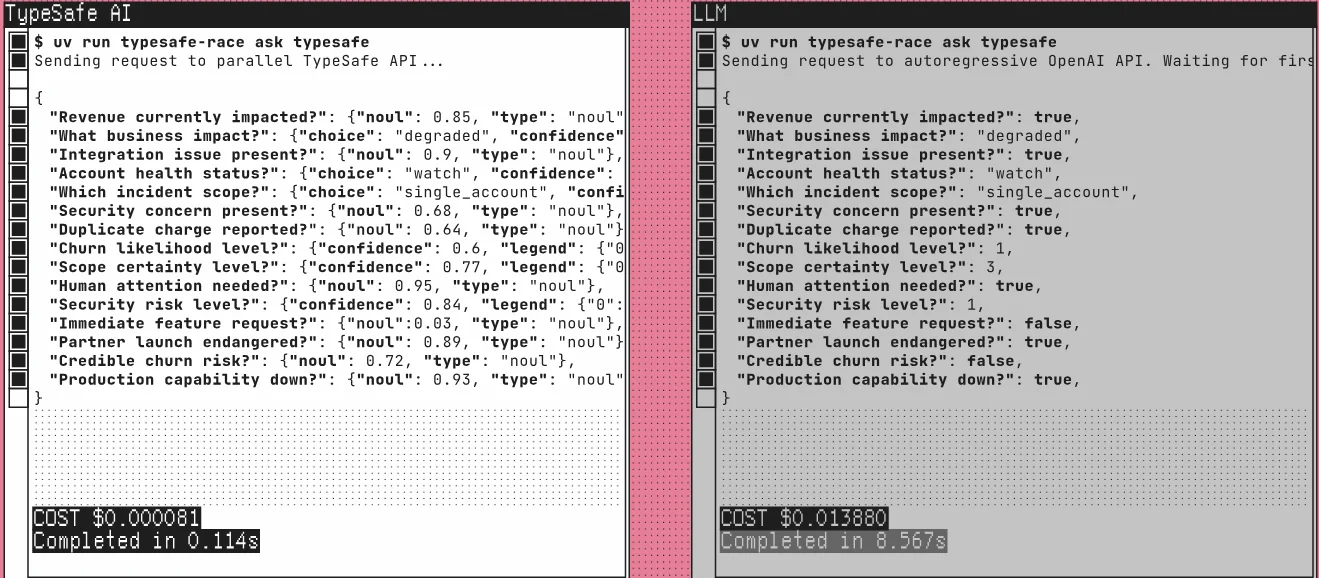
De bron beschrijft dat Jev antwoorden in een vooraf bepaald formaat levert, in de praktijk dicht tegen JSON aan. Dat is een belangrijk verschil met een gewone chatbot, die vaak nog apart moet worden aangestuurd om kort, gestructureerd en machineleesbaar te antwoorden. Omdat Jev al in een strikt dataformaat werkt, hoeft een ontwikkelaar minder tijd te steken in promptconstructies of in het afdwingen van een bepaald antwoordpatroon. De output is dus minder bedoeld voor menselijke lezing en meer voor directe verwerking door code.
Ook de manier waarop context wordt aangeboden verschilt van een klassieke LLM. Volgens Tom’s Hardware krijgt Jev per verzoek een toestand mee: een bepaalde situatie en de bijbehorende data. De bron benadrukt dat die toestand bij iedere afzonderlijke aanvraag opnieuw wordt meegegeven en dat er geen wereldwijde kennisbank of blijvende geheugenlaag in de sessie aanwezig is. Dat maakt Jev minder afhankelijk van eerdere interacties en minder geschikt voor open gesprekken, maar juist praktischer in een workflow waarin een systeem alleen de relevante gegevens hoeft te beoordelen.
De publicatie noemt daarnaast dat Jev niet vanzelf uit de hele voorgeschiedenis van een vraag put. In tegenstelling tot chatbots, waar een lange context vaak nodig is om het gesprek coherent te houden, is bij Jev juist sprake van een beperkte en specifieke context. De modelinvoer moet dus nauw aansluiten op de vraag die software wil stellen. Dat past bij de positie van Jev als instrument voor probabilistische besluitvorming in plaats van als allesomvattende assistent.
Claims over snelheid en kosten
TypeSafe zegt dat Jev veel sneller en goedkoper is dan frontiermodellen. In de bron wordt gesproken over een claim van tot 193x sneller en 445x goedkoper, terwijl op een andere plek in dezelfde tekst ook “up to 194x faster” staat. Die kleine afwijking laat zien dat het om een bedrijfsclaim gaat en niet om een onafhankelijke meting die in de bron wordt uitgelegd of gevalideerd. De strekking blijft wel hetzelfde: TypeSafe wil duidelijk maken dat Jev in zijn niche een veel efficiëntere route biedt dan grote generatieve modellen.
De reden voor die efficiëntiewinst ligt volgens het bedrijf in twee technische keuzes. Ten eerste is Jev getraind met Reinforcement Learning for Calibrated Decisions, afgekort RLCD. Dat is een trainingsaanpak die niet gericht is op het produceren van vloeiende prose, maar op gestructureerde beslissingen met een goed gekalibreerde kansinschatting. Daarmee verschuift de optimalisatie van taalproductie naar besluitvorming.
Ten tweede kunnen losse vragen binnen één verzoek parallel worden verwerkt, omdat Jev geen tekst hoeft op te bouwen alsof het een lopend gesprek is. Waar een LLM doorgaans woord voor woord of token voor token genereert, kan dit model meerdere onderdelen van een vraag naast elkaar beoordelen. Dat is volgens de bron vooral nuttig in situaties waarin verschillende voorwaarden tegelijk moeten worden gecontroleerd. In plaats van een lang antwoord te construeren, levert het systeem dan een set beslissingen of waarschijnlijkheden af die direct bruikbaar zijn voor vervolglogica.
De bron koppelt die efficiëntie expliciet aan codegebruik. Omdat Jev geen uitgebreid gesprek onderhoudt en niet afhankelijk is van een lang contextvenster om zijn output te formuleren, hoeft de software die het model aanroept minder rekenwerk en minder orkestratielogica te verzorgen rondom taaloutput. Tom’s Hardware beschrijft dat als een interface die dichter bij een eenvoudige beoordeling-respons-confidence-opzet ligt dan bij de gebruikelijke chatinteractie met LLM’s.
Waar Jev volgens TypeSafe wel en niet voor bedoeld is
TypeSafe geeft aan dat Jev bedoeld is voor concrete, afgebakende situaties waarin software een beslissing moet nemen. De bron noemt voorbeelden als het beoordelen of een gebruiker om een terugbetaling vraagt, het controleren van een citaat of het inschatten of er sprake is van een serieus systeemprobleem. In zulke gevallen kan Jev een ja/nee-uitkomst geven met een waarschijnlijkheidspercentage. Ook kan het model een verdeling over meerdere opties opleveren, bijvoorbeeld refund, store credit of unclear.
Die probabilistische opzet maakt het model geschikt voor workflows waarin software stap voor stap verder reageert op basis van de zekerheid van de uitkomst. Tom’s Hardware beschrijft bijvoorbeeld een situatie waarin een applicatie eerst vaststelt of een klant waarschijnlijk een refund wil. Als die kans hoog genoeg is, kan de software vervolgens een vervolgvraag stellen over de gewenste afhandelingsmethode. Zo ondersteunt Jev niet alleen een eerste ja/nee-inschatting, maar ook een vervolgproces waarin meerdere keuzes mogelijk zijn.
Belangrijk is wel dat de uiteindelijke beslissing niet door Jev zelf wordt genomen. De bron benadrukt dat de ontwikkelaar de verantwoordelijkheid houdt om op basis van de confidence factor te bepalen wat er gebeurt. Het model is dus geen autonome agent die zelf een probleem oplost, maar een beslismodule die bestaande software helpt bij het kiezen van de volgende stap. Dat maakt de rol van het model overzichtelijker, maar zet ook duidelijk een grens aan wat Jev wel en niet moet doen.
De bron waarschuwt bovendien dat Jev nog steeds fouten kan maken. Het model kan informatie verkeerd classificeren, gevoelig zijn voor adversarial input of te letterlijk reageren op de formulering van een vraag. Anders gezegd: probabilistische besluitvorming betekent niet dat het model automatisch gelijk heeft. De output blijft een inschatting, geen garantie.
TypeSafe noemt daarnaast use cases zoals intent routing en citation checking. Dat zijn taken waarin een systeem snel moet bepalen welke categorie, route of controle van toepassing is. Voor dat soort toepassingen lijkt de aanpak van Jev volgens de bron goed te passen. Voor bredere taken, zoals het analyseren van logs of het schrijven van een rapport, is een LLM volgens TypeSafe juist beter geschikt. In zo’n workflow kan Jev eerst de eerste beoordeling doen en daarna een LLM inzetten als er meer onderzoek nodig is.
Opvallend is ook dat de bron aangeeft dat Jev geen model is dat klantdata uit zichzelf in zich opneemt of daaruit conclusies trekt buiten de aangeleverde toestand om. De kennis waarop het antwoord is gebaseerd, komt uit de input en uit de training, niet uit een blijvende globale geheugenlaag. Daardoor blijft de scope van probabilistische besluitvorming klein en gecontroleerd. Dat is tegelijk de kracht en de beperking van het systeem: het is niet bedoeld om een open probleem te overdenken, maar om heel gericht te zeggen of iets waarschijnlijk klopt en hoe zeker het model daarvan is.
TostieTech duiding
De interessantste stap van Jev is niet de snelheidsclaim, maar de poging om AI minder chat-achtig en meer softwarematig te maken. Veel huidige LLM-toepassingen worden nu nog gebruikt als generieke tekstmotor, terwijl een groot deel van de praktijk eigenlijk draait om classificatie, routing en beslissen onder onzekerheid. Juist daar kan een model dat expliciet met confidence scores werkt aantrekkelijk zijn.
Tegelijk is de positionering ook een beperking. Jev lijkt niet bedoeld voor open redeneren of voor taken waarbij context en uitleg belangrijk zijn. Dat maakt het concept technisch netter, maar ook smaller. Voor consumenten en ontwikkelaars betekent dat vooral dat Jev waarschijnlijk niet de chatbot vervangt, maar een andere laag in de softwarestack kan zijn: een model dat je laat zeggen of iets waarschijnlijk waar is, waarna je eigen code verder beslist.
Bron: Tom's Hardware