

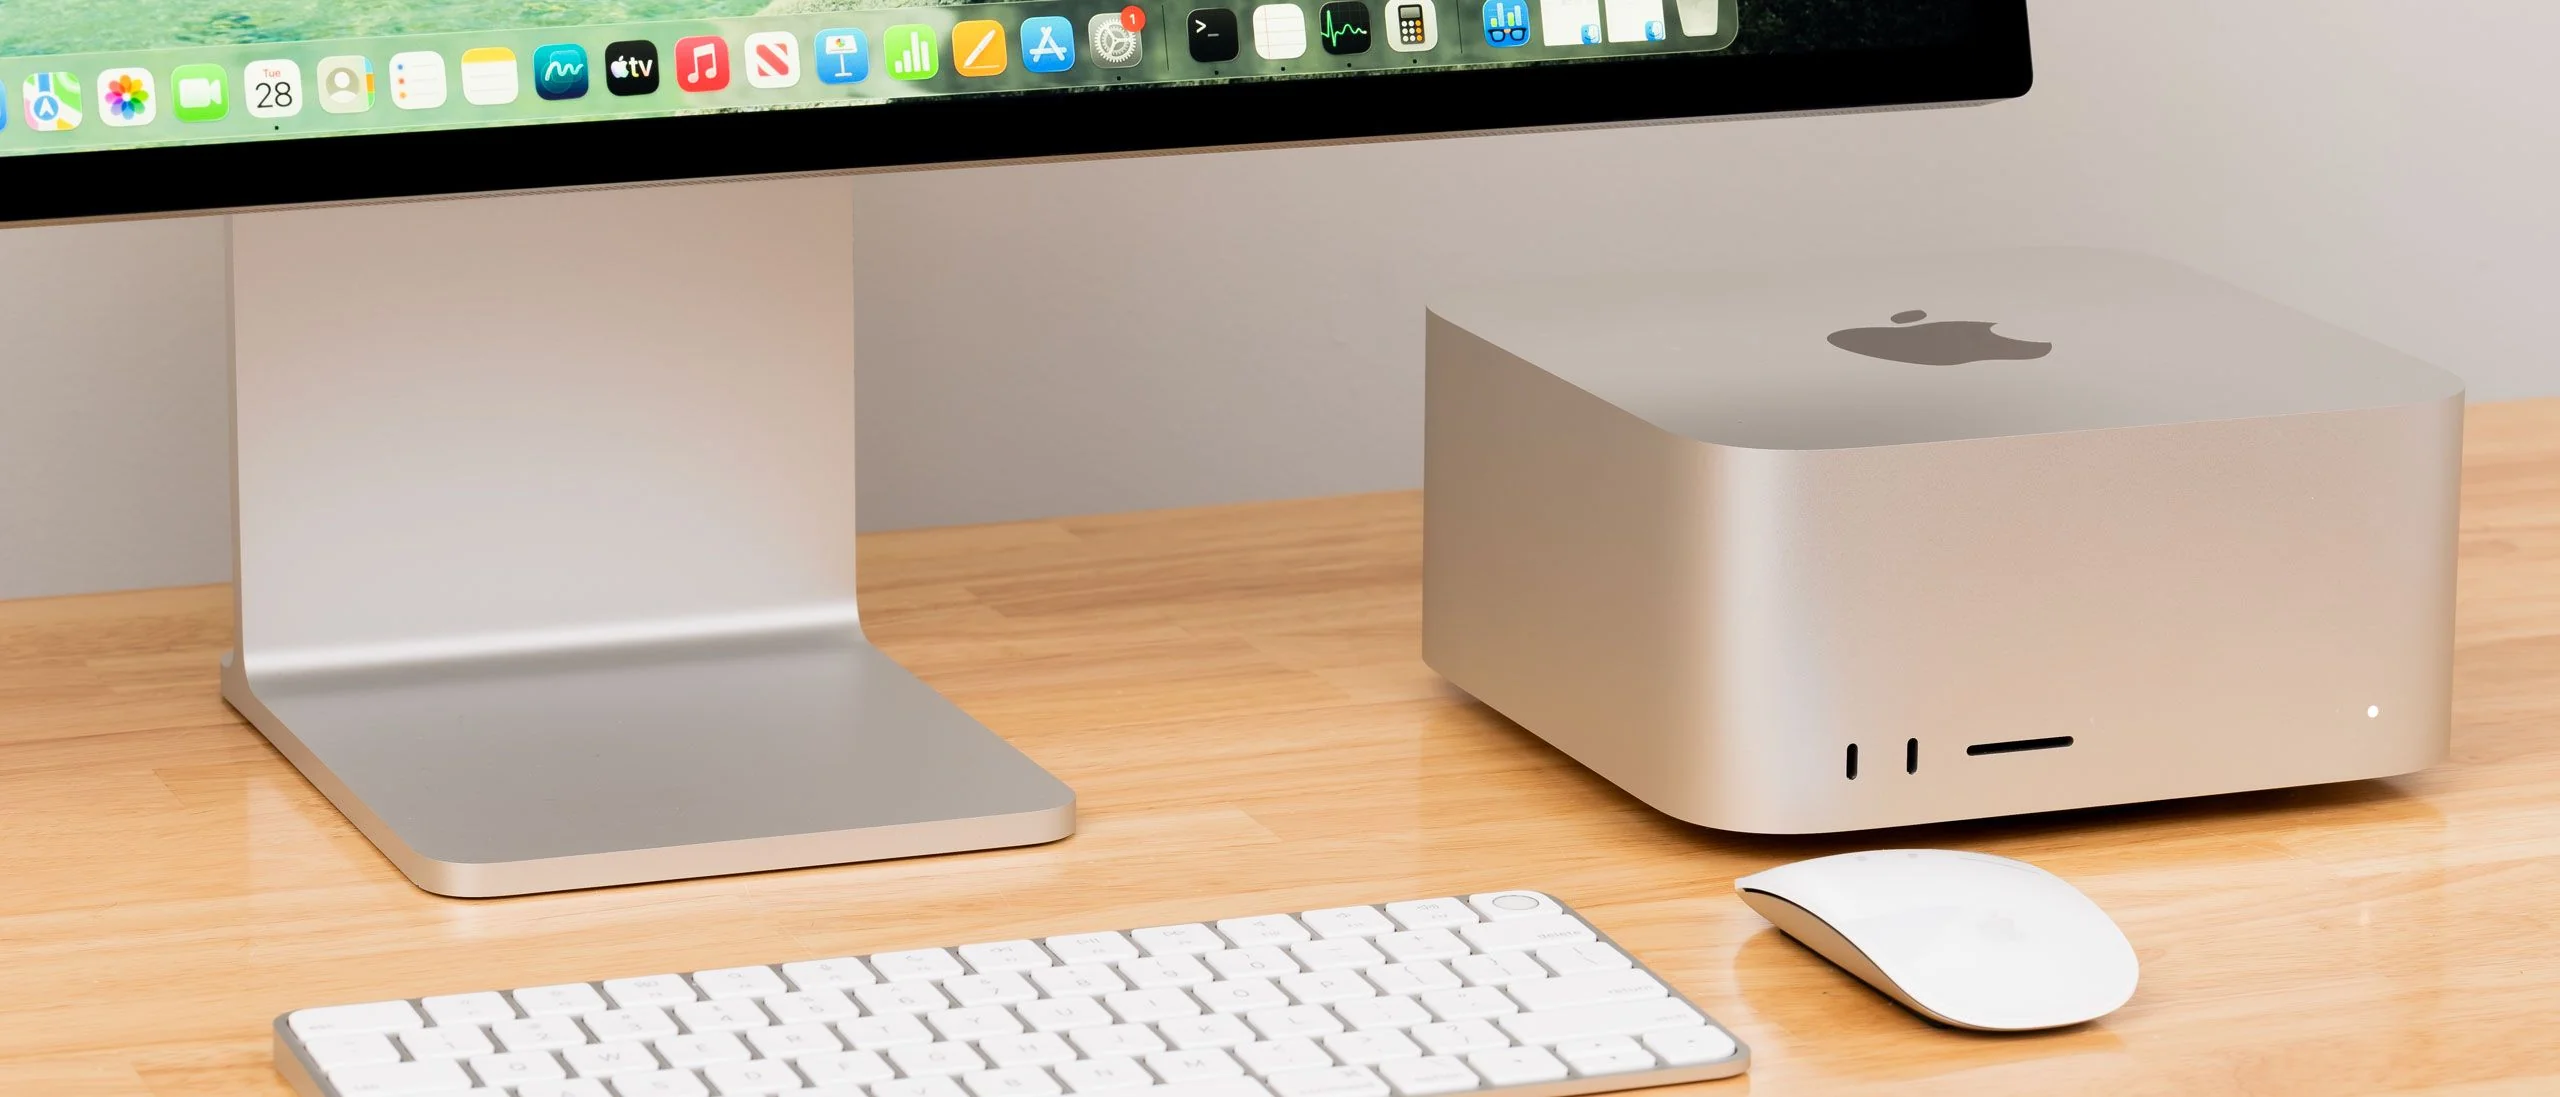
In tests van Tom’s Hardware laat de Mac Studio met M5 Ultra zien dat lokale AI-prestaties niet alleen draaien om rekenkracht en geheugenbandbreedte. De machine kan in sommige workloads sneller en zuiniger zijn dan een Nvidia DGX Spark-achtig systeem, maar dat hangt sterk af van het model en de inferentie-engine. Vooral bij grotere AI-modellen blijkt de softwarestack een doorslaggevende factor voor lokale AI-prestaties.
Meer technologienieuws vind je op de TostieTech Tech-nieuwspagina.
Wat betekent de lokale AI-prestaties?
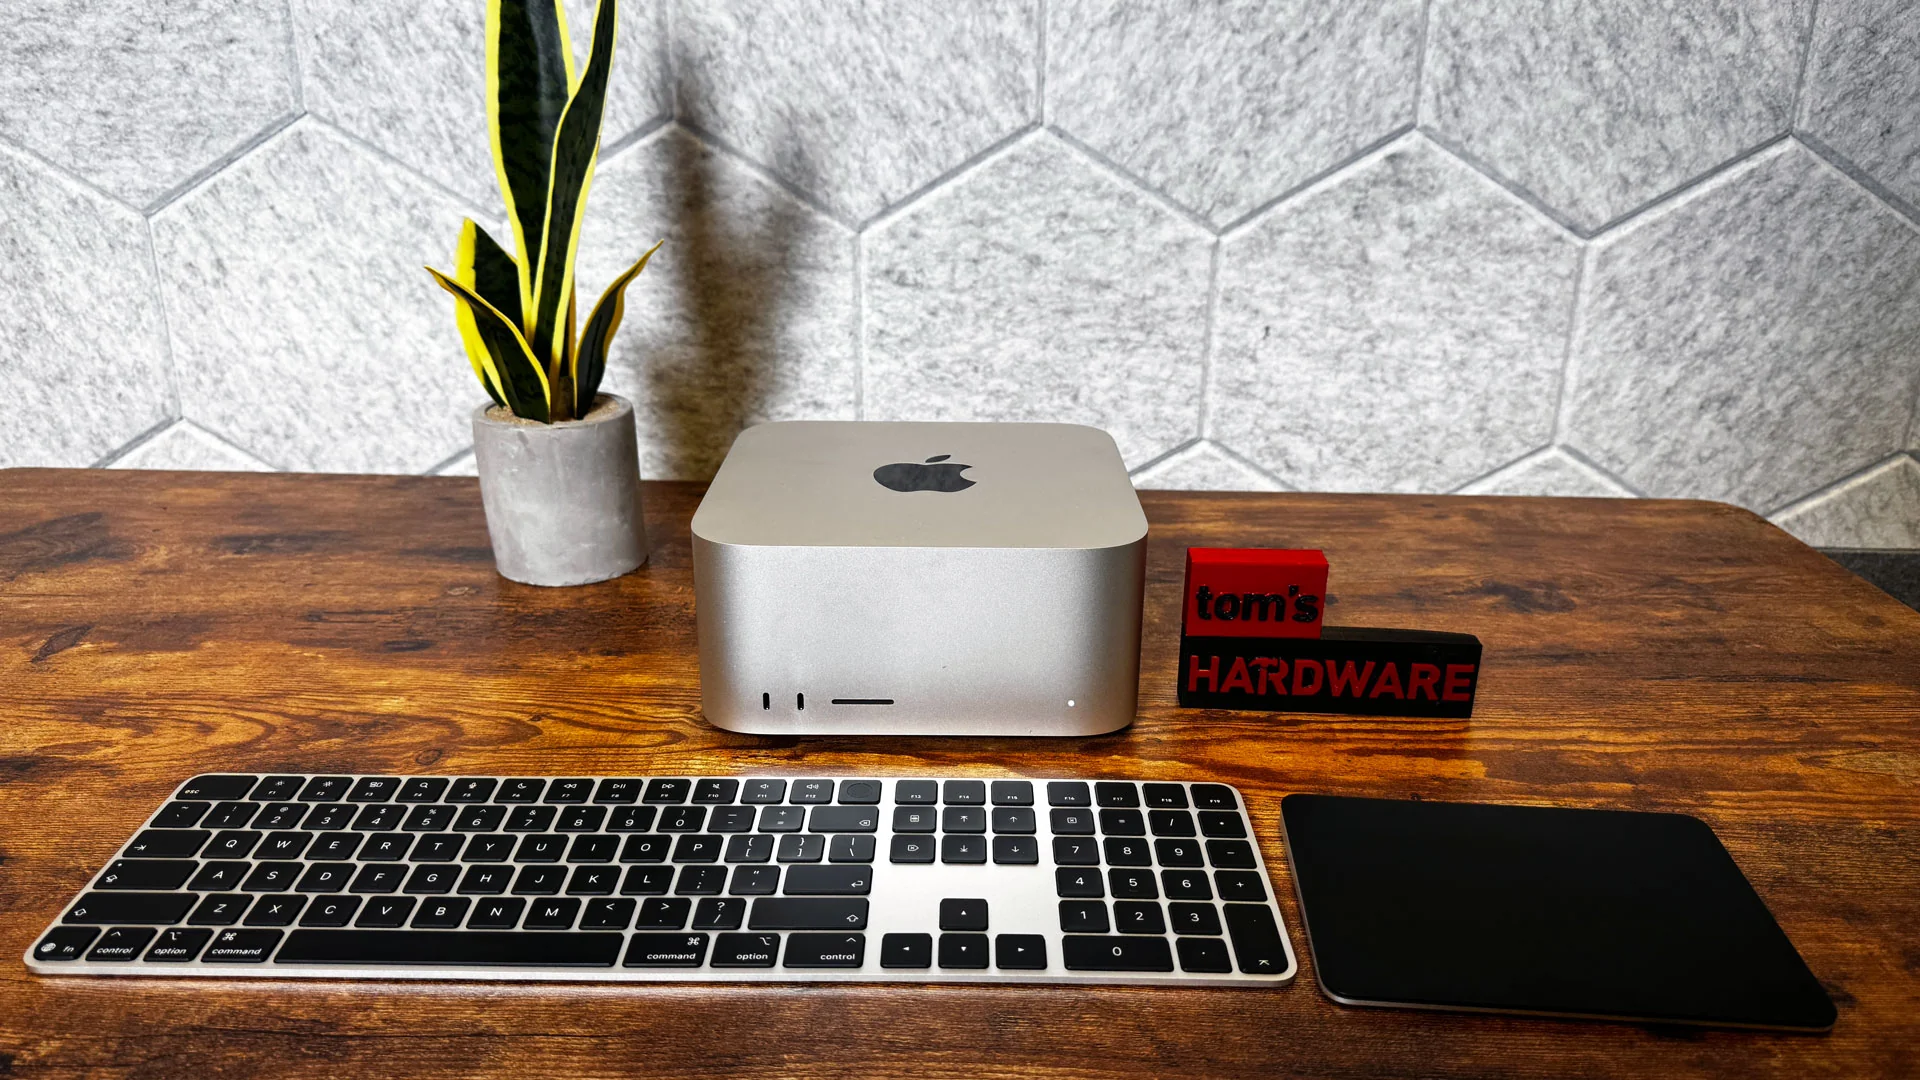
Tom’s Hardware onderzocht de Mac Studio met M5 Ultra als platform voor lokale AI-inferentie en zette die af tegen een Dell Pro Precision GB10-systeem dat sterk lijkt op Nvidia’s DGX Spark. Dat is een relevante vergelijking, omdat beide systemen zich richten op serieuze lokale AI-gebruikers die veel geheugen en hoge doorvoer nodig hebben. De geteste Mac Studio-configuratie was allesbehalve bescheiden: een 36-core CPU, een 80-core GPU met Neural Accelerators en tot 512 GB unified memory zijn bedoeld voor zware workloads. De publicatie noemt een prijs van ruim 12.000 dollar voor de geteste opstelling en meldt ook levertijden van 13 tot 15 weken voor sommige configuraties.
De vergelijking draait daarbij niet alleen om pure rekenkracht, maar ook om hoe die hardware in de praktijk uitpakt bij agentische AI-taken. Tom’s Hardware wijst erop dat de Mac Studio op papier veel geheugenbandbreedte heeft en daarmee in theorie goed gepositioneerd is voor promptverwerking en decodewerk. Tegelijk maakt de test duidelijk dat ruwe specificaties niet automatisch het hele verhaal vertellen. Juist bij lokale AI-prestaties spelen factoren als de gekozen backend en de manier waarop een model wordt ondersteund een grote rol.
In de eerste benchmarks werd Qwen 3.8 27B gebruikt, een relatief compact maar nog steeds veeleisend model. Daarbij draaide op beide systemen llama.cpp als inferentie-backend, met native multi-token prediction ingeschakeld. In die test rondde de Mac Studio de AgentPerf-Local-workload in bijna de helft van de tijd af ten opzichte van één DGX Spark-achtig systeem. Ook op energiegebied scoorde de Mac goed: het systeem verbruikte ongeveer 16 procent minder energie voor dezelfde taak. Daarmee was de energie-delay product-score van de Mac Studio minder dan de helft van die van de Spark-achtige machine. Dat laat zien dat lokale AI-prestaties niet alleen om snelheid gaan, maar ook om efficiëntie per afgewerkte taak.
Lokale AI-prestaties hangen sterk af van het model
De belangrijkste nuance uit het artikel is dat deze voorsprong niet voor elk model geldt. Tom’s Hardware ging verder met grotere open modellen zoals DeepSeek V4.1 Flash 1017 en GLM 5.3 Flash om te zien wat er gebeurt wanneer het geheugen van de Mac Studio echt zwaar wordt belast. Die modellen passen wel in de Mac, maar niet op een enkele 128 GB DGX Spark. Nvidia’s antwoord daarop is clustering: meerdere Spark-systemen samen inzetten om genoeg geheugen en rekenkracht te krijgen.
Daarmee ontstaat direct een ander speelveld. Een cluster van twee GB10-systemen kost volgens Tom’s Hardware al snel 15.000 tot 20.000 dollar, afhankelijk van opslag en partnerconfiguratie, en dus meer dan een enkele Mac Studio. Toch blijkt de uitkomst niet simpelweg in het voordeel van Apple te vallen. Voor DeepSeek moest de Mac Studio terugvallen op llama.cpp, zonder extra hulp van een aparte speculative decoding-model. Het Spark-cluster kon daarentegen gebruikmaken van een DeepSeek-serving recipe met TensorFold en DSpark speculative decoding. Daardoor was het cluster bij lange contexten soms binnen vijf minuten klaar, terwijl de Mac Studio 10 tot 25 minuten nodig had om dezelfde input te verwerken.
Dat verschil is belangrijk voor gebruikers die met langere prompts of complexere agentische workflows werken. De test maakt duidelijk dat de Mac Studio met M5 Ultra wel degelijk veel in huis heeft, maar dat de uitvoering van het model en de beschikbare optimalisaties bepalen hoeveel daarvan ook daadwerkelijk benut wordt. Bij DeepSeek wint Nvidia dus duidelijk op lokale AI-prestaties, mede dankzij betere softwareondersteuning en een inferentiepad dat meer geoptimaliseerd is voor deze workload.
MLX groeit, maar Nvidia heeft nog het bredere ecosysteem
Bij GLM 5.3 Flash kwam een ander beeld naar voren. Met llama.cpp deed de Mac Studio het al beter dan bij DeepSeek, maar het Spark-cluster bleef sneller in promptverwerking. Wel laat Tom’s Hardware zien dat Apple Silicon meer in zijn mars heeft dan de basisbenchmark suggereert: wanneer voor GLM 5.3 Flash een TensorFold-serving recipe beschikbaar is, springt de Mac Studio flink vooruit. Promptverwerking komt dichter bij die van het Spark-cluster en de decode-throughput wordt gemiddeld zelfs ongeveer drie keer zo hoog.
Die sprong onderstreept dat de M5 Ultra niet per se tekortschiet, maar dat de softwarestack nog niet overal even ver is. Het artikel benadrukt dat de ondersteuning rond MLX nog in ontwikkeling is en dat Nvidia-hardware profiteert van een veel breder ecosysteem. Daar zijn vaker direct recipes, engines en community-aanpassingen beschikbaar voor nieuwe modellen. Bij Apple is dat minder vanzelfsprekend, waardoor de prestaties per model sterker kunnen schommelen.
Tom’s Hardware laat daarmee zien dat lokale AI-prestaties niet alleen moeten worden beoordeeld op de chip of de hoeveelheid geheugen alleen. De combinatie van model, quantisatie, inferentie-engine en ondersteuning binnen de MLX-stack bepaalt of een dure Mac Studio zijn potentieel benut. Voor GLM 5.3 Flash blijkt dat potentieel duidelijk aanwezig, maar alleen wanneer de juiste softwarelaag beschikbaar is. Zonder zo’n optimalisatie blijft een deel van de capaciteit onbenut, zelfs als de hardware op zichzelf indrukwekkend is.
Wat dit betekent voor kopers van lokale AI-hardware
De praktische conclusie is genuanceerd. Voor gebruikers die vooral één krachtige, compacte en stille werkstationmachine willen, kan de Mac Studio met M5 Ultra een aantrekkelijke keuze zijn. Zeker als lokale AI slechts één onderdeel is van een bredere workflow, biedt de combinatie van CPU, GPU, geheugenbandbreedte en compacte behuizing veel in één systeem. In sommige tests is de machine ronduit sterk en efficiënt, vooral bij het kleinere Qwen 3.8 27B-model.
Maar wie juist specifiek investeert in een lokale AI-setup van meer dan 10.000 dollar, moet verder kijken dan alleen de hardware-architectuur. Nvidia’s DGX Spark-achtige systemen hebben een duidelijk voordeel als het gaat om schaalbaarheid, modelcompatibiliteit en beschikbare softwarepaden voor nieuwe modellen. Tom’s Hardware benadrukt dat community-ondersteuning in de praktijk vaak het verschil maakt tussen een systeem dat theoretisch sterk is en een systeem dat meteen bruikbaar is voor nieuwe AI-modellen.
Ook de kosten van opschaling spelen mee. Een enkele Mac Studio is duur, maar een cluster van twee GB10-systemen kan volgens de test nog duurder uitpakken. Tegelijk levert zo’n cluster wel de extra geheugenruimte en de softwareopties op die nodig zijn voor grotere modellen. Daarmee verschuift de vraag voor kopers van alleen “welk systeem is het snelst?” naar “welk systeem is het snelst voor mijn model, mijn workload en mijn softwarepad?”. Voor wie maximale zekerheid wil dat een nieuw model snel lokaal draait, blijft Nvidia voorlopig de veiligere keuze. Voor wie bereid is te wachten op een rijpere MLX-stack, kan de Mac Studio juist verrassend aantrekkelijk zijn.
TostieTech duiding
De test laat goed zien dat lokale AI-prestaties niet meer op één as te meten zijn. Apple heeft met de M5 Ultra duidelijk genoeg geheugenbandbreedte en rekenkracht om in bepaalde workloads hard te scoren, maar de uitkomst wordt bepaald door het volledige softwarepad: model, quantisatie, backend en beschikbare optimalisaties. Juist daar zit het verschil met Nvidia. De DGX Spark-achtige systemen winnen niet per se omdat de ruwe hardware altijd beter is, maar omdat het ecosysteem rond die hardware volwassener is. Voor consumenten en kleine teams betekent dat dat de keuze niet alleen gaat over snelheid per dollar, maar ook over hoeveel tijd je wilt steken in het passend maken van modellen en recipes. De Mac Studio is daarmee een indrukwekkend platform voor lokale AI, maar niet automatisch de meest probleemloze.
Bron: Tom's Hardware